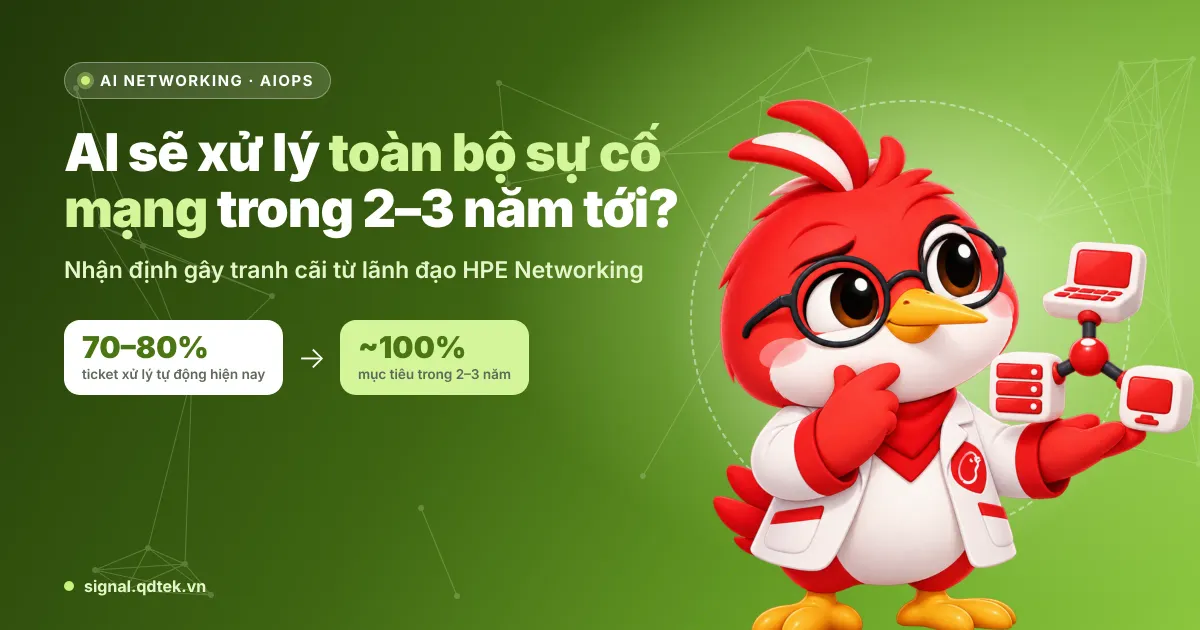
Rami Rahim, cựu CEO Juniper Networks, hiện là Chủ tịch kiêm Tổng giám đốc mảng Networking của Hewlett Packard Enterprise (HPE), vừa đưa ra một nhận định gây chú ý trong cuộc phỏng vấn với The Register ngày 11/10/2026:
Trong vòng 2–3 năm tới, các sự cố mạng có thể được xử lý hoàn toàn mà không cần kỹ sư can thiệp trực tiếp.
Đây không đơn thuần là một câu chuyện về tự động hóa. Nó phản ánh sự chuyển dịch lớn trong cách doanh nghiệp xây dựng, vận hành và quản trị hạ tầng mạng – đặc biệt khi AI đang trở thành yếu tố trung tâm trong mọi hoạt động kinh doanh.
1. Bối cảnh: Thương vụ HPE – Juniper và sự ra đời của một "đế chế" Networking mới
Để hiểu tại sao nhận định của Rahim có trọng lượng, cần nhìn vào bối cảnh.
Tháng 1/2024, HPE công bố kế hoạch mua lại Juniper Networks với giá khoảng 14 tỷ USD – một trong những thương vụ lớn nhất lịch sử ngành mạng. Sau quá trình phê duyệt kéo dài từ cơ quan quản lý cạnh tranh (bao gồm cả Bộ Tư pháp Mỹ và EU), thương vụ được hoàn tất vào đầu năm 2025.
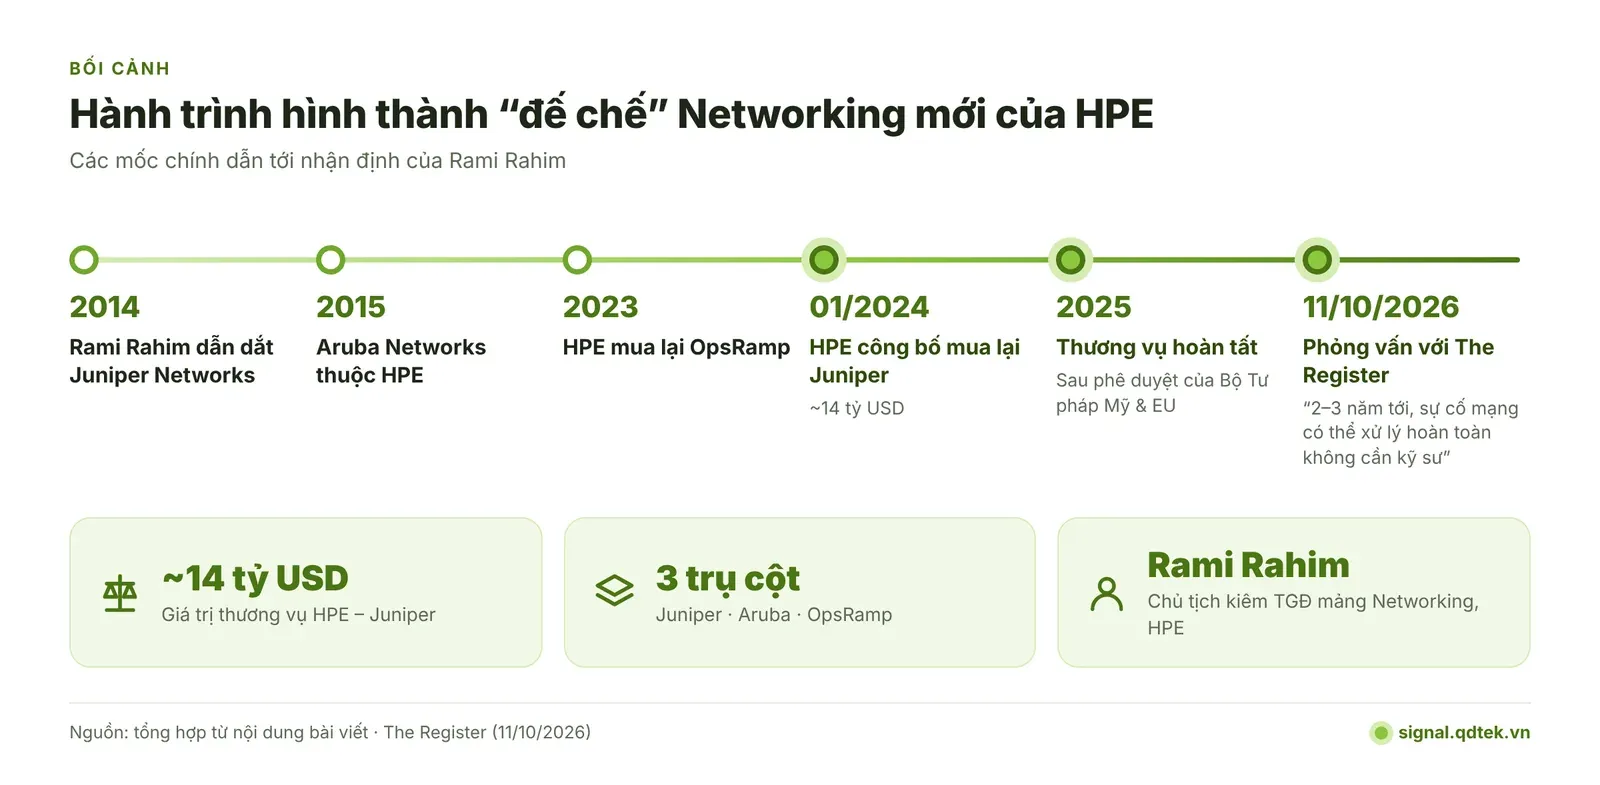
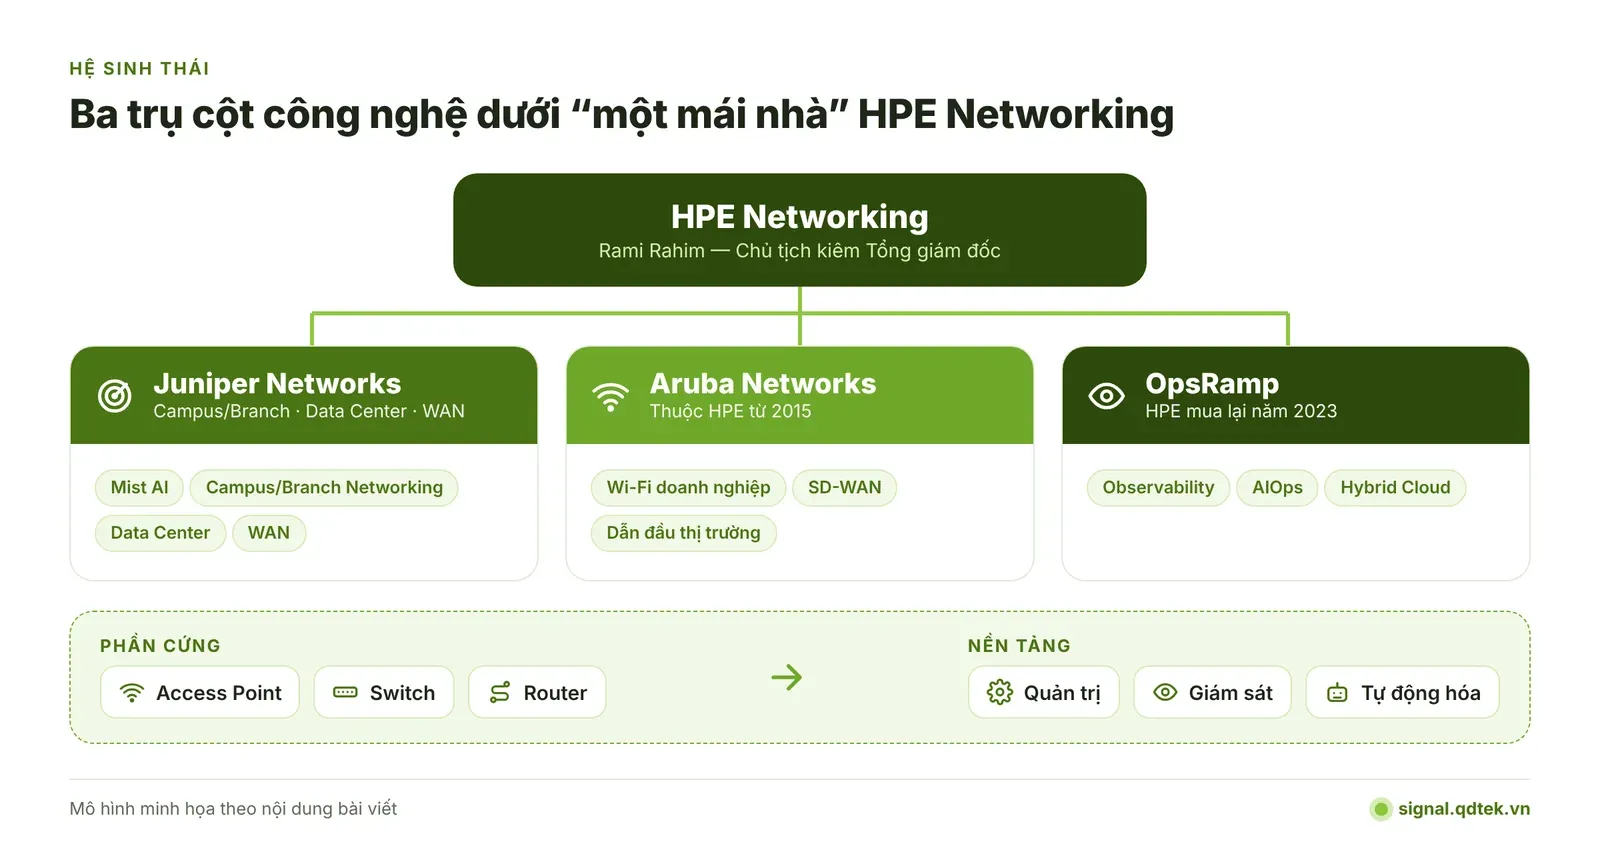
Sau sáp nhập, Rami Rahim – người đã dẫn dắt Juniper từ năm 2014 – tiếp tục đảm nhiệm vai trò lãnh đạo toàn bộ mảng Networking của HPE. Dưới quyền ông bây giờ là ba trụ cột công nghệ:
- Juniper Networks – mạnh về Campus/Branch Networking với nền tảng Mist AI, cùng dòng sản phẩm Data Center và WAN.
- Aruba Networks (thuộc HPE từ 2015) – dẫn đầu thị trường Wi-Fi doanh nghiệp và SD-WAN.
- OpsRamp (HPE mua lại năm 2023) – nền tảng Observability và AIOps cho môi trường Hybrid Cloud.
Sự kết hợp này tạo ra một hệ sinh thái hiếm có: từ Access Point, Switch, Router cho đến nền tảng quản trị, giám sát và tự động hóa – tất cả nằm trong cùng một mái nhà.
2. Từ AIOps đến Self-Driving Networks: Con số 70–80% và mục tiêu gần 100%
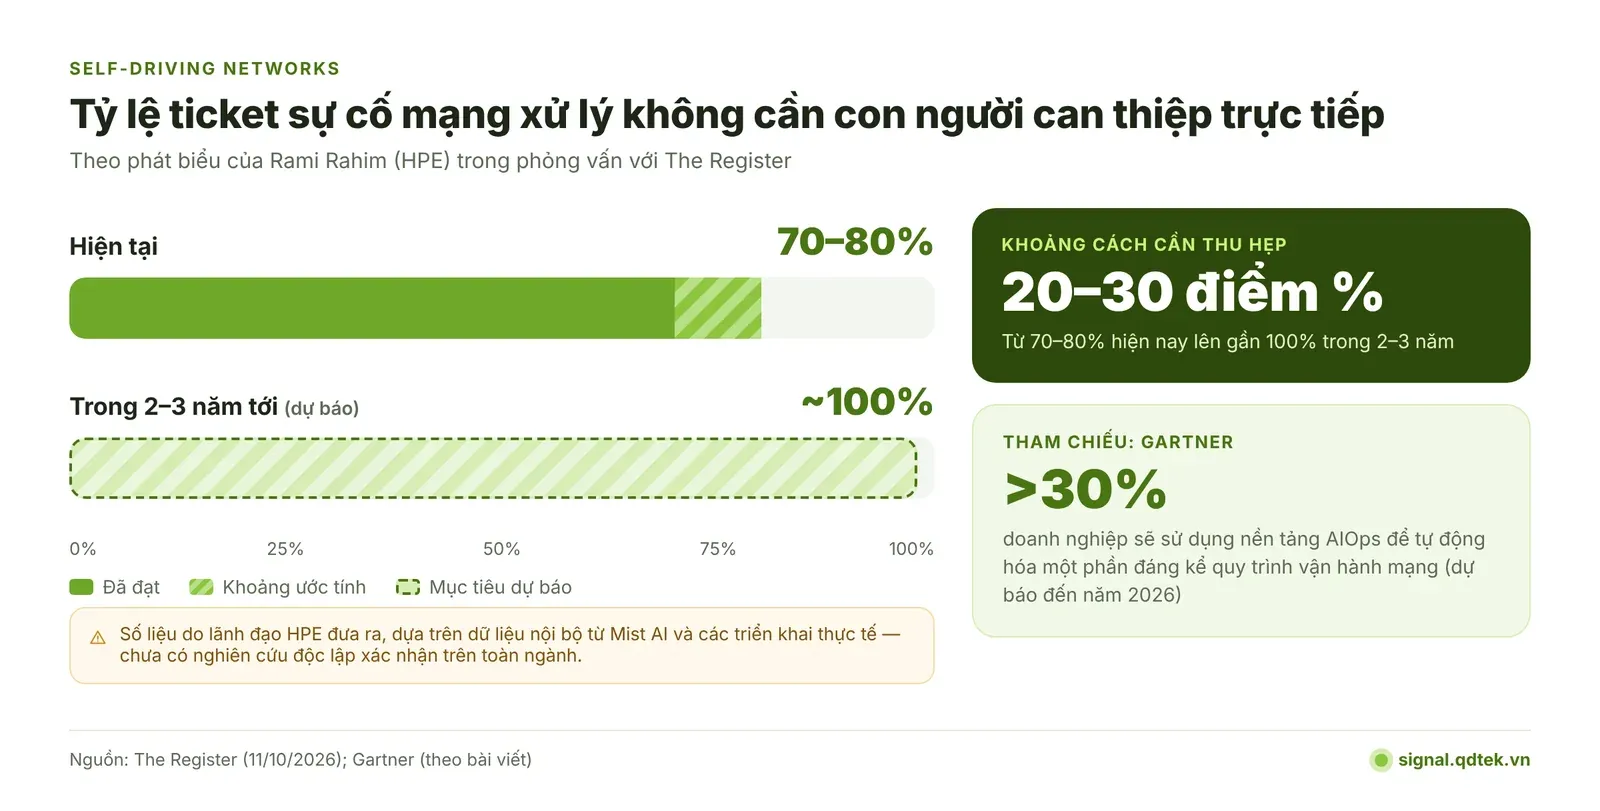
Trong cuộc phỏng vấn, Rahim cho biết hiện tại khoảng 70–80% ticket sự cố mạng đã có thể được xử lý mà không cần sự can thiệp trực tiếp của con người. Ông dự đoán con số này sẽ tiến tới gần 100% trong vòng 2–3 năm.
Cần lưu ý: đây là con số do lãnh đạo HPE đưa ra, dựa trên dữ liệu nội bộ từ nền tảng Mist AI và các triển khai thực tế. Chưa có nghiên cứu độc lập nào xác nhận tỷ lệ này trên phạm vi toàn ngành. Tuy nhiên, nó phù hợp với xu hướng mà nhiều nhà phân tích đã ghi nhận: Gartner từng dự báo rằng đến năm 2026, hơn 30% doanh nghiệp sẽ sử dụng nền tảng AIOps để tự động hóa một phần đáng kể quy trình vận hành mạng.
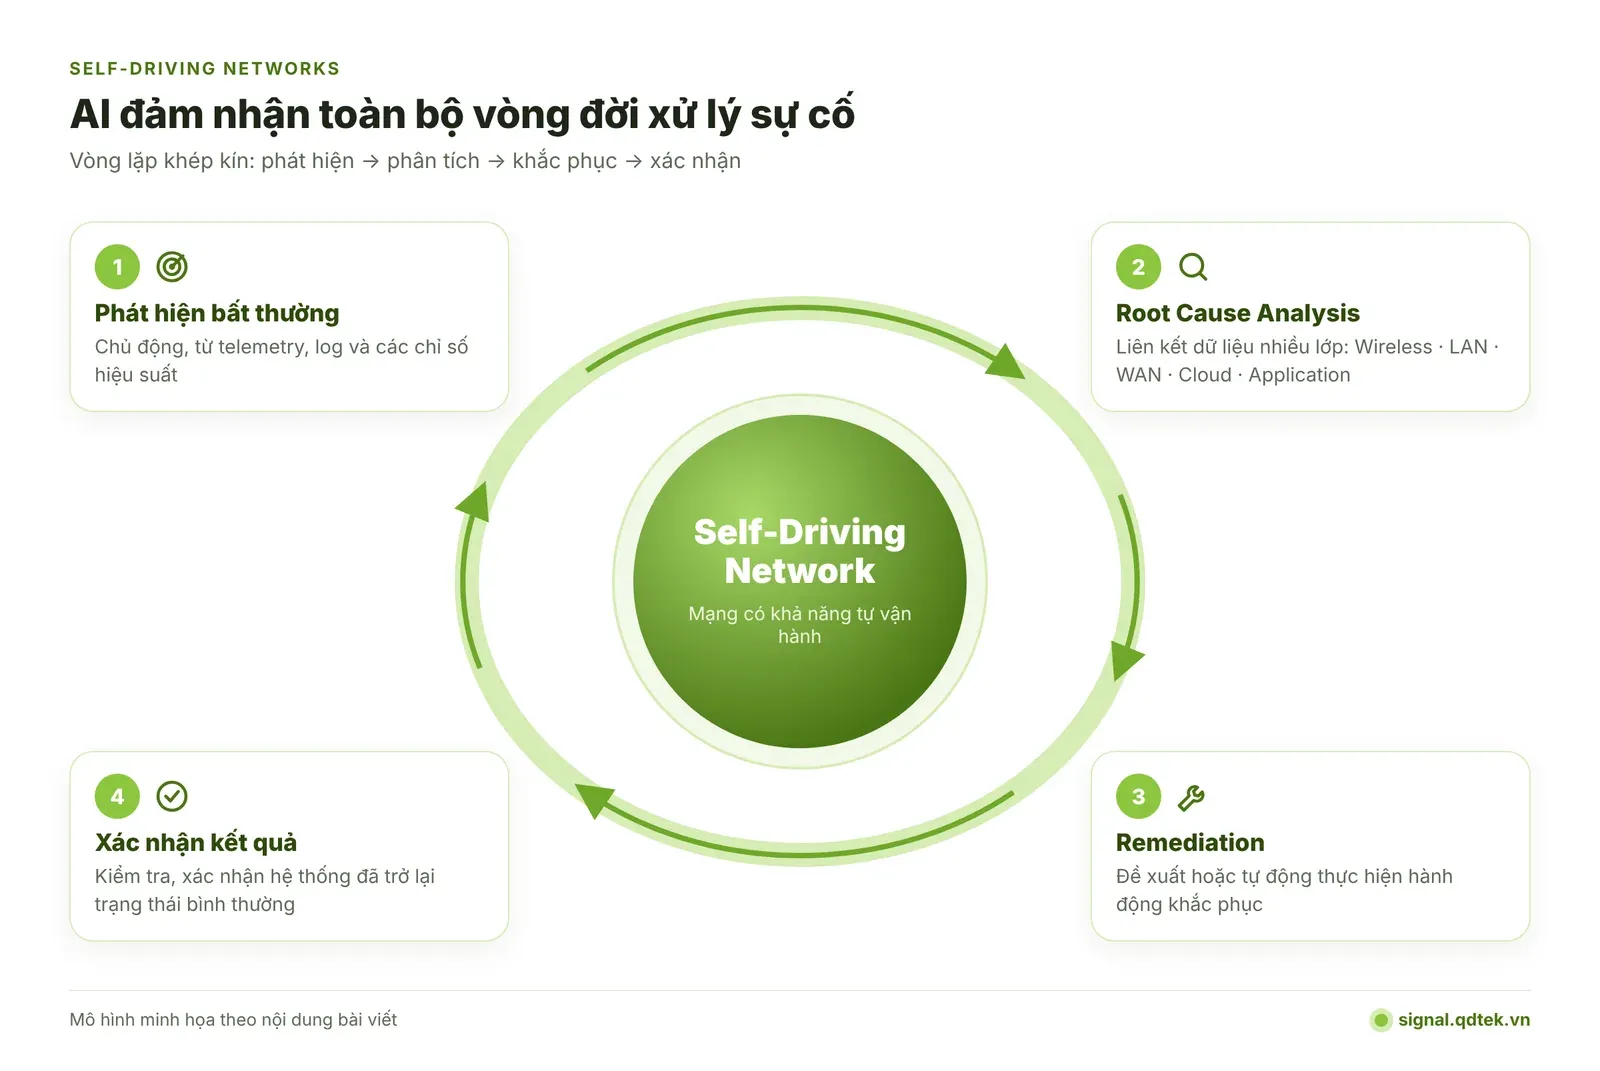
Để đạt mục tiêu "gần 100%", HPE đang đẩy mạnh khái niệm Self-Driving Networks – mạng có khả năng tự vận hành. Ý tưởng cốt lõi là hệ thống AI sẽ đảm nhận toàn bộ vòng đời xử lý sự cố:
- Chủ động phát hiện bất thường từ telemetry, log và các chỉ số hiệu suất.
- Thực hiện Root Cause Analysis (phân tích nguyên nhân gốc rễ), liên kết dữ liệu từ nhiều lớp: Wireless, LAN, WAN, Cloud, Application.
- Đề xuất hoặc tự động thực hiện hành động khắc phục (remediation).
- Kiểm tra kết quả, xác nhận hệ thống đã trở lại trạng thái bình thường.
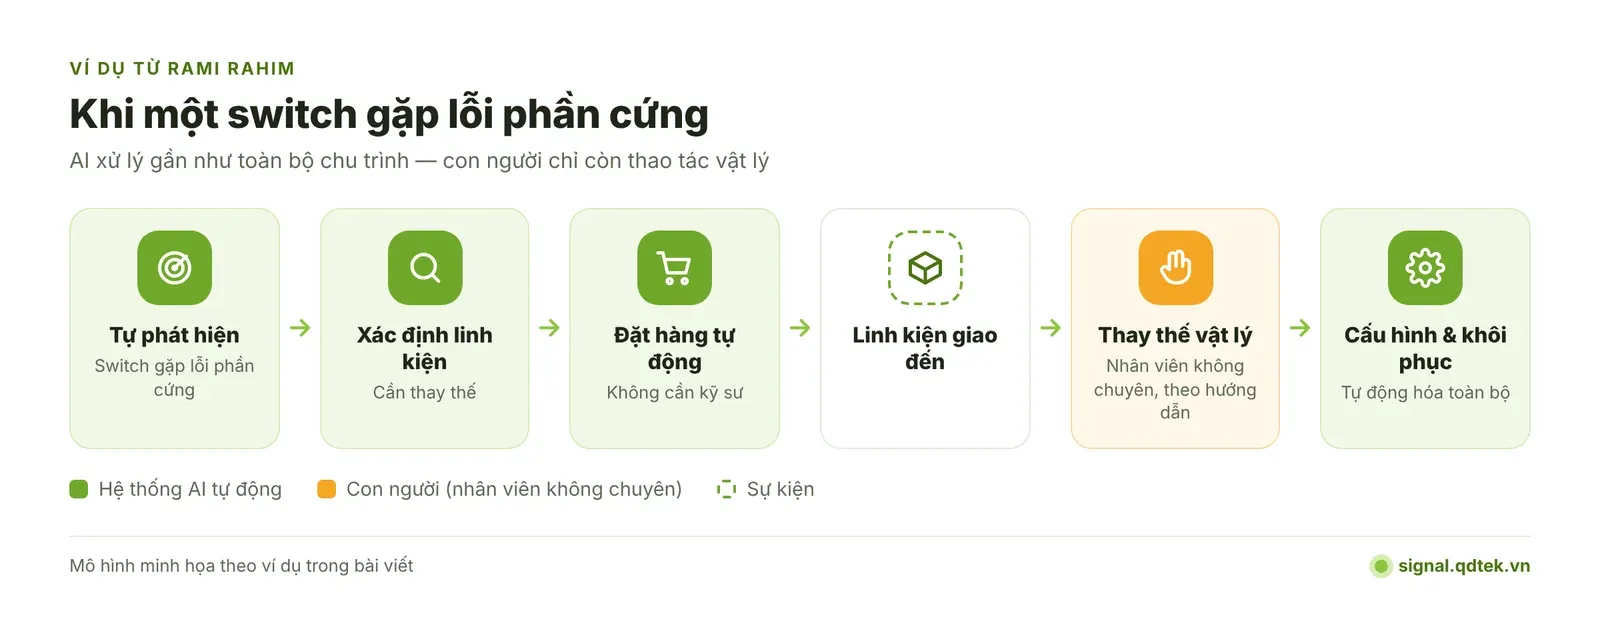
Ví dụ cụ thể mà Rahim đề cập: khi một switch gặp lỗi phần cứng, hệ thống có thể tự phát hiện, xác định linh kiện cần thay thế, thậm chí đặt hàng tự động. Khi linh kiện được giao đến, một nhân viên không chuyên có thể thực hiện thao tác thay thế vật lý theo hướng dẫn. Toàn bộ phần cấu hình và khôi phục dịch vụ sẽ được tự động hóa.
3. Tại sao Wi-Fi là bài toán lý tưởng cho AIOps?
Một chi tiết đáng chú ý trong cuộc phỏng vấn: Rahim cho biết ticket phổ biến nhất trong mạng doanh nghiệp thường chỉ có nội dung ngắn gọn: "The Wi-Fi sucks!" (Wi-Fi quá tệ!).
Nhưng vấn đề thực sự thường không nằm ở Wi-Fi.
Người dùng chỉ cảm nhận được rằng ứng dụng chạy chậm khi dùng Wi-Fi. Còn nguyên nhân gốc rễ có thể nằm ở bất kỳ đâu trong chuỗi: Access Point quá tải, nhiễu sóng, DHCP/DNS gặp sự cố, đường truyền WAN bị nghẽn, ứng dụng trên Cloud phản hồi chậm, hoặc một dịch vụ Backend ngừng hoạt động.
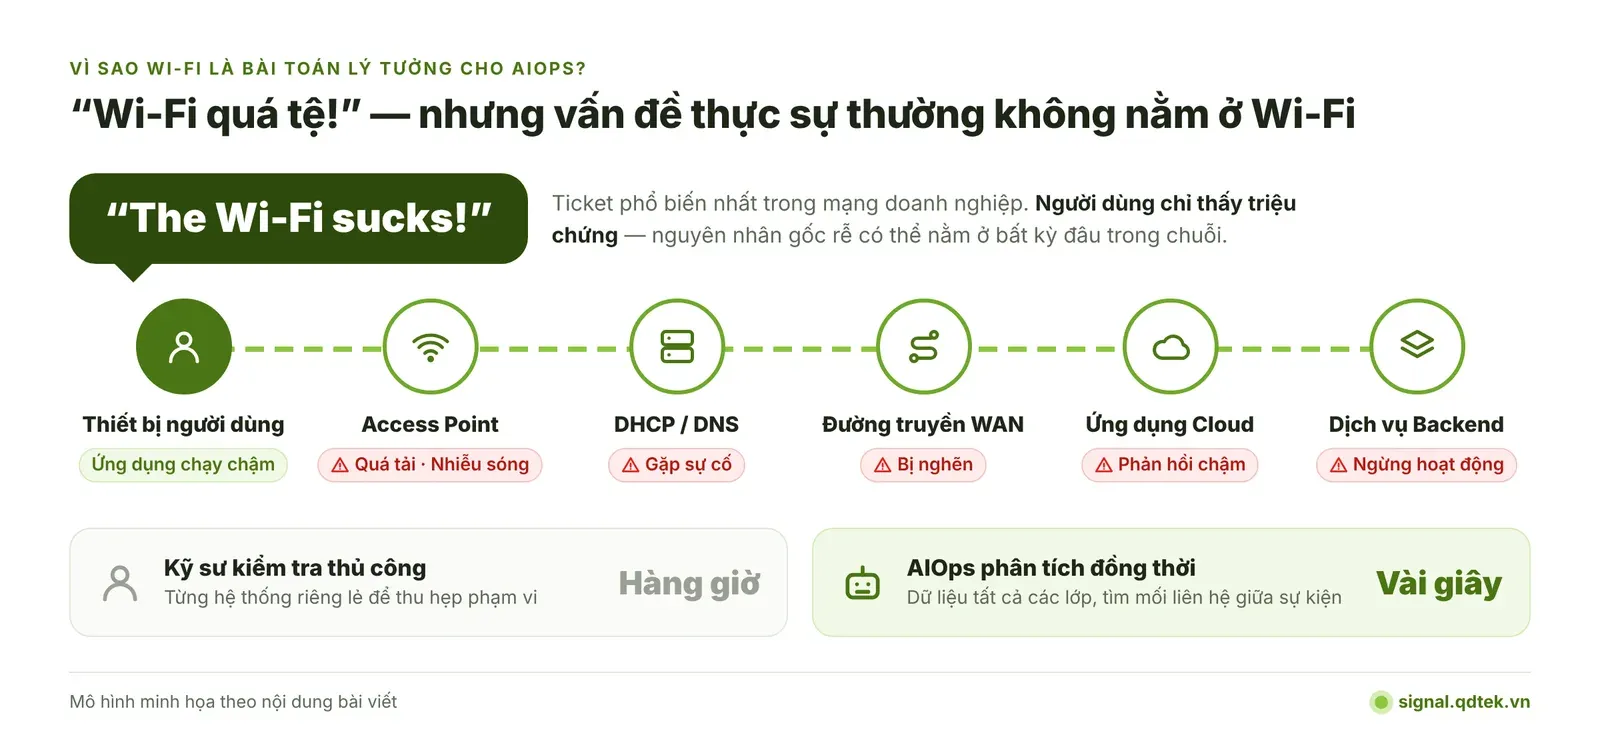
Đây chính là tình huống AIOps phát huy thế mạnh. Thay vì kỹ sư phải kiểm tra từng hệ thống riêng lẻ – mất hàng giờ để thu hẹp phạm vi – AI có thể phân tích đồng thời dữ liệu từ tất cả các lớp và tìm ra mối liên hệ giữa các sự kiện trong vài giây.
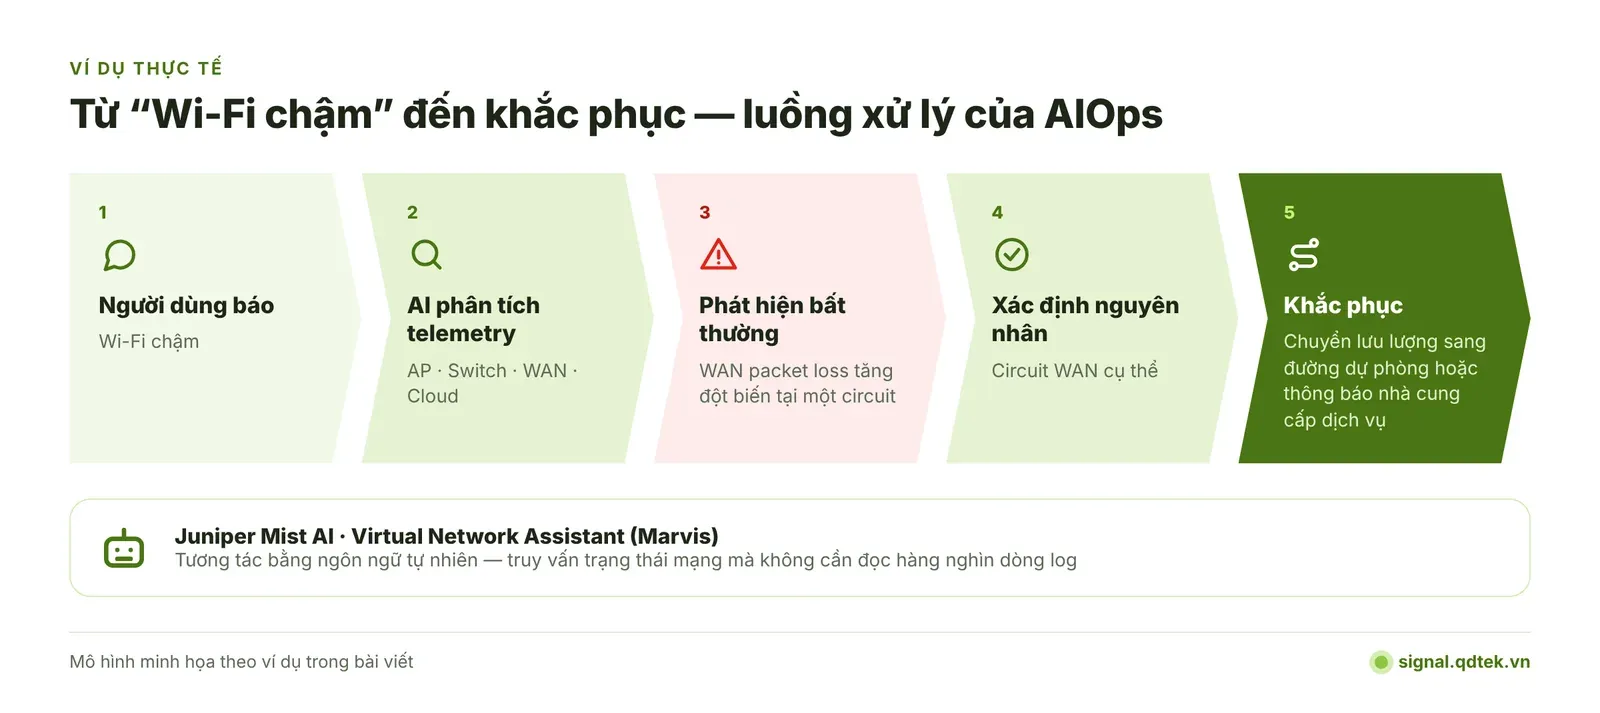
Ví dụ thực tế: Người dùng báo Wi-Fi chậm → AI phân tích telemetry từ AP, Switch, WAN, Cloud → phát hiện WAN packet loss tăng đột biến tại một circuit cụ thể → xác định đây là nguyên nhân → tự động chuyển lưu lượng sang đường dự phòng hoặc thông báo cho nhà cung cấp dịch vụ.
Juniper Mist AI – nền tảng mà HPE đang kế thừa và mở rộng – vốn nổi tiếng trong cộng đồng Networking vì khả năng phân tích Wi-Fi bằng AI. Hệ thống sử dụng Virtual Network Assistant (Marvis) để tương tác bằng ngôn ngữ tự nhiên, giúp người dùng truy vấn trạng thái mạng mà không cần đọc hàng nghìn dòng log.
4. Khi doanh nghiệp có nhiều AI Agent hơn nhân viên
Rahim đưa ra một dự báo khác đáng suy ngẫm: Trong tương lai gần, doanh nghiệp có thể sở hữu nhiều AI Agent đang hoạt động hơn số lượng nhân viên thực.
Những AI Agent này thực hiện đủ loại công việc: phân tích dữ liệu, xử lý giao dịch, tương tác với khách hàng, truy cập API, gọi các dịch vụ nội bộ. Tất cả đều cần hạ tầng mạng ổn định, độ trễ thấp và khả năng mở rộng linh hoạt.
Điều này tạo ra một nghịch lý thú vị: doanh nghiệp triển khai AI để tăng năng suất, nhưng chính AI lại tạo ra áp lực khổng lồ lên hạ tầng mạng. Khi số lượng Agent tăng lên, lưu lượng mạng, số kết nối đồng thời và yêu cầu giám sát đều tăng theo. Doanh nghiệp không thể liên tục tuyển thêm kỹ sư để xử lý mọi sự cố phát sinh từ lượng workload gia tăng này.
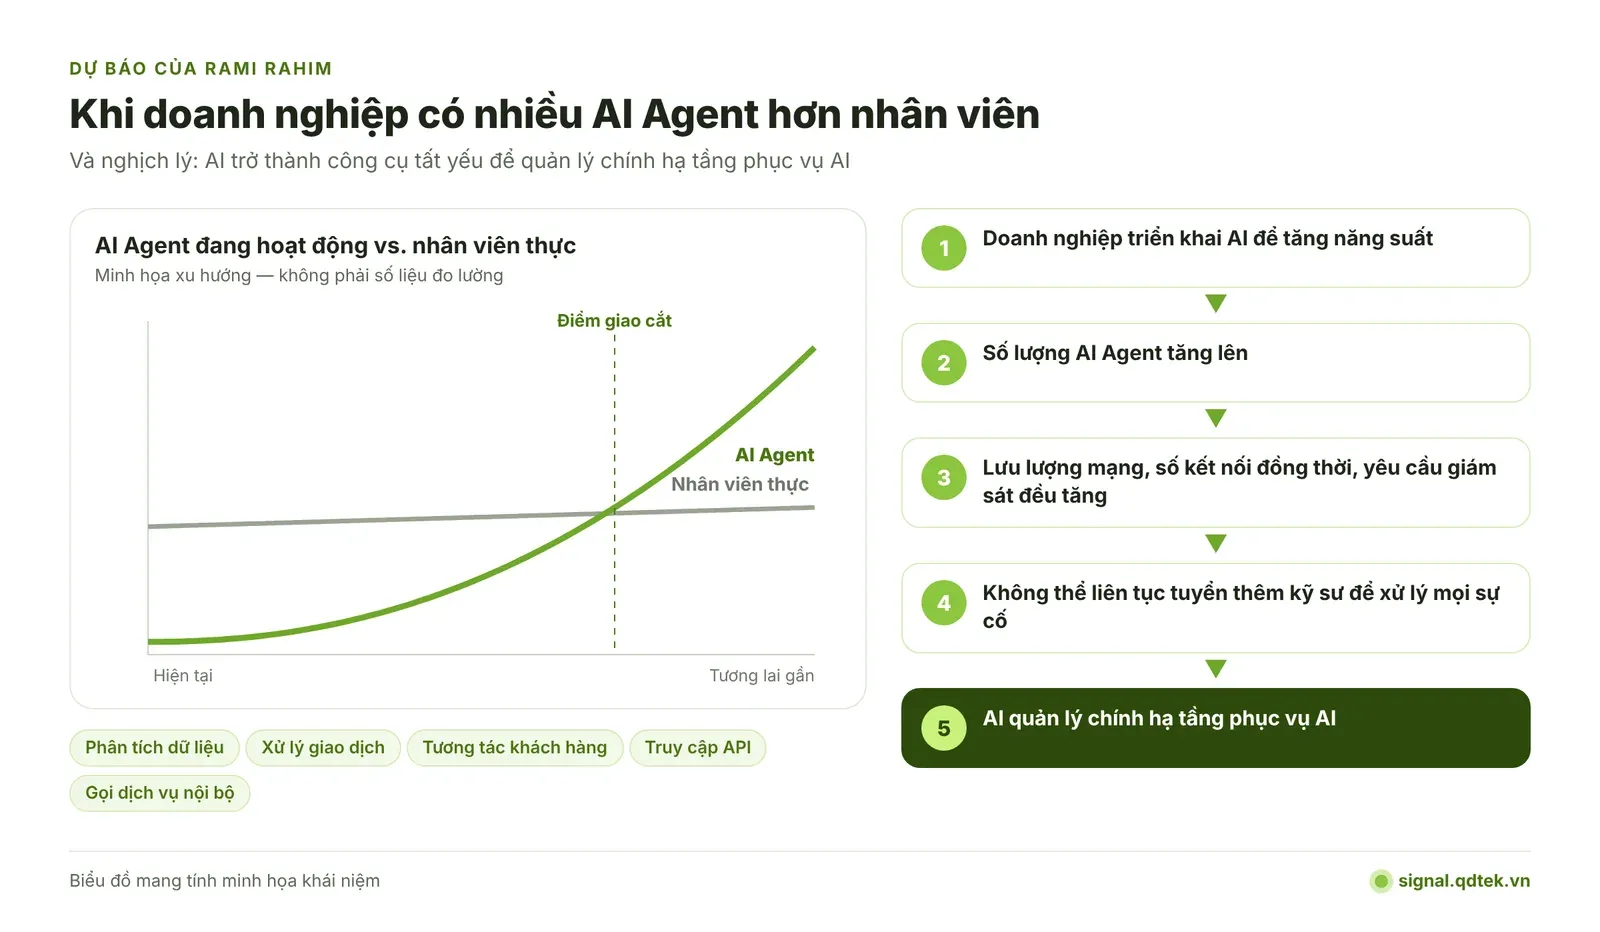
Vì vậy, theo Rahim, AI trở thành công cụ tất yếu để quản lý chính hạ tầng phục vụ AI. Đây không phải logic vòng tròn – mà là sự phản ánh thực tế rằng quy mô vận hành đang vượt xa khả năng xử lý thủ công của con người.
5. Vấn đề niềm tin: Làm sao giao phó hạ tầng mạng cho AI?
The Register đặt ra câu hỏi mấu chốt: Tại sao kỹ sư mạng phải tin tưởng AI, khi một quyết định sai có thể gây sập toàn bộ hệ thống?
Rahim so sánh quá trình này với ngành ô tô. Con người không nhảy thẳng từ lái số sàn sang xe tự lái. Trước tiên là hộp số tự động, rồi đến Cruise Control, Lane Assist, và dần dần là các hệ thống tự hành cao hơn. Niềm tin được xây dựng từng bước, qua những trải nghiệm tự động hóa thành công ở mức độ thấp trước.
Ông đề xuất doanh nghiệp triển khai Network Automation theo cách tương tự:
- Bước 1: Cho phép AI thực hiện thao tác đơn giản – ví dụ khởi động lại một switch port bị treo.
- Bước 2: Khi hệ thống chứng minh độ tin cậy, mở rộng sang các tác vụ phức tạp hơn – như thay đổi cấu hình VLAN hoặc điều chỉnh QoS policy.
- Bước 3: Tiến đến tự động hóa toàn bộ quy trình khắc phục sự cố, kèm theo xác nhận kết quả.
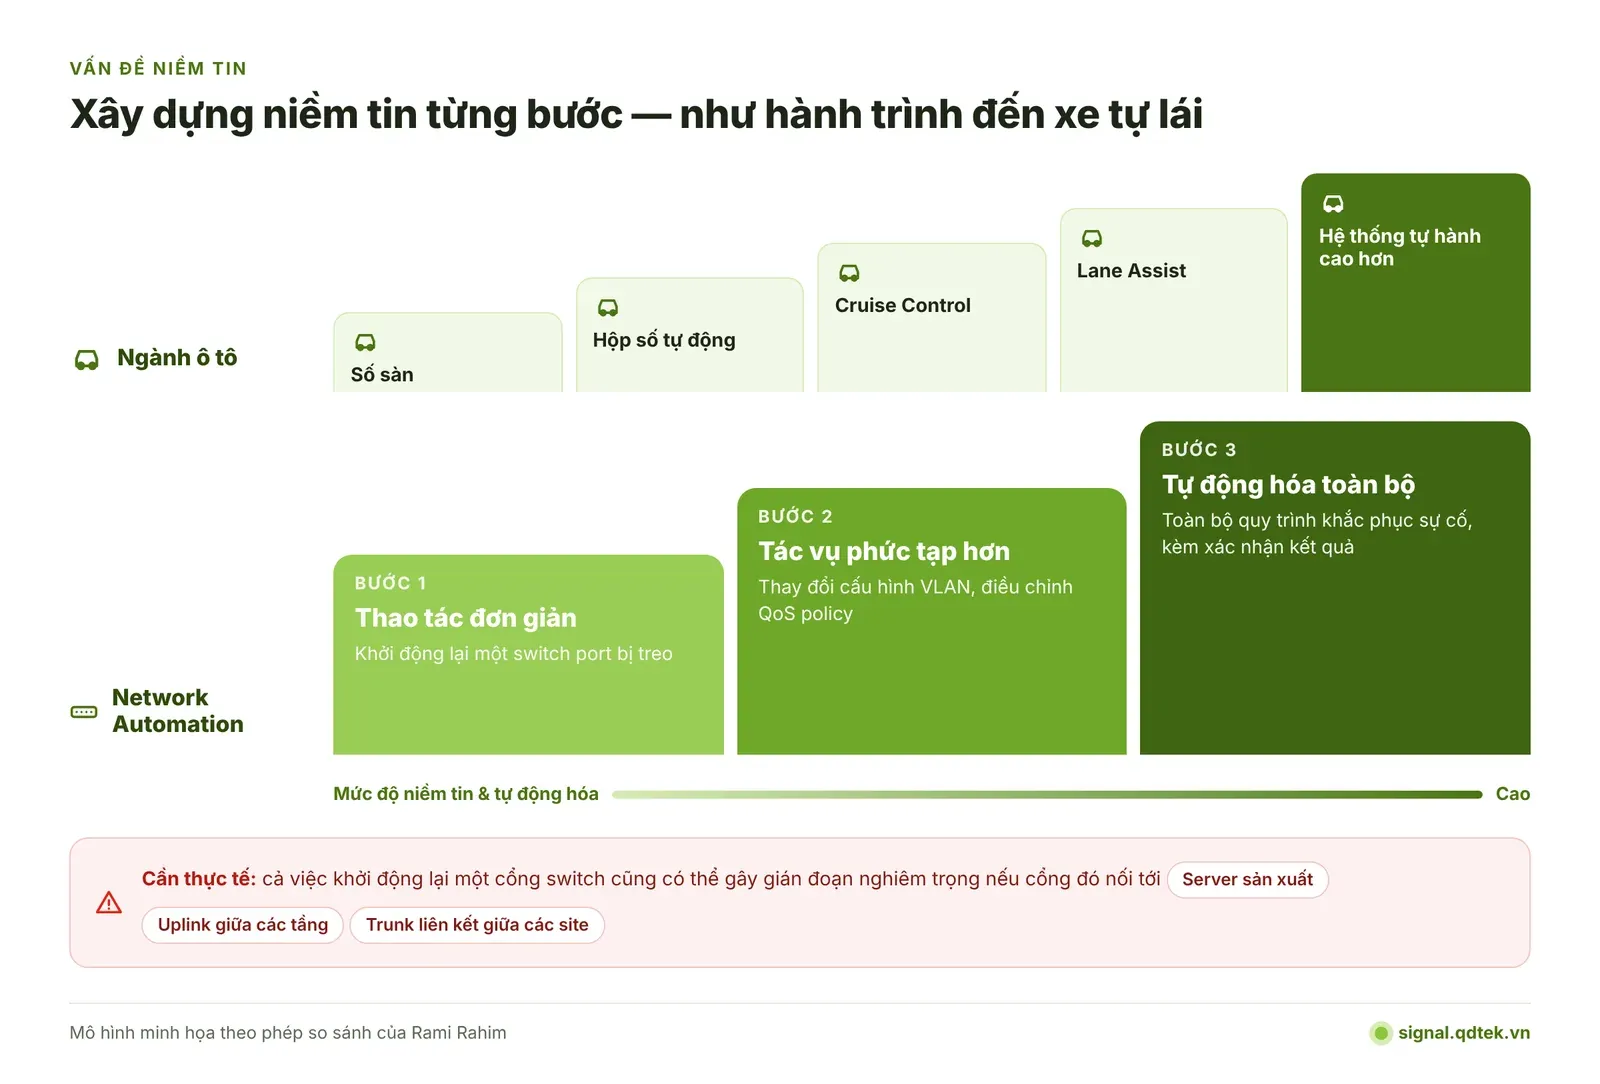
Tuy nhiên, cần thực tế: ngay cả thao tác tưởng chừng đơn giản như khởi động lại một cổng switch cũng có thể gây gián đoạn nghiêm trọng nếu cổng đó kết nối đến thiết bị quan trọng – một server sản xuất, một uplink giữa các tầng, hay một đường trunk liên kết giữa các site.
Vì vậy, AI cần được triển khai cùng các lớp kiểm soát:
- Guardrails: giới hạn phạm vi hành động AI được phép thực hiện.
- RBAC (Role-Based Access Control): phân quyền rõ ràng.
- Change Control: mọi thay đổi phải qua quy trình phê duyệt.
- Audit Logs: ghi nhận đầy đủ để truy vết.
- Human-in-the-Loop: con người vẫn phê duyệt các hành động có rủi ro cao.
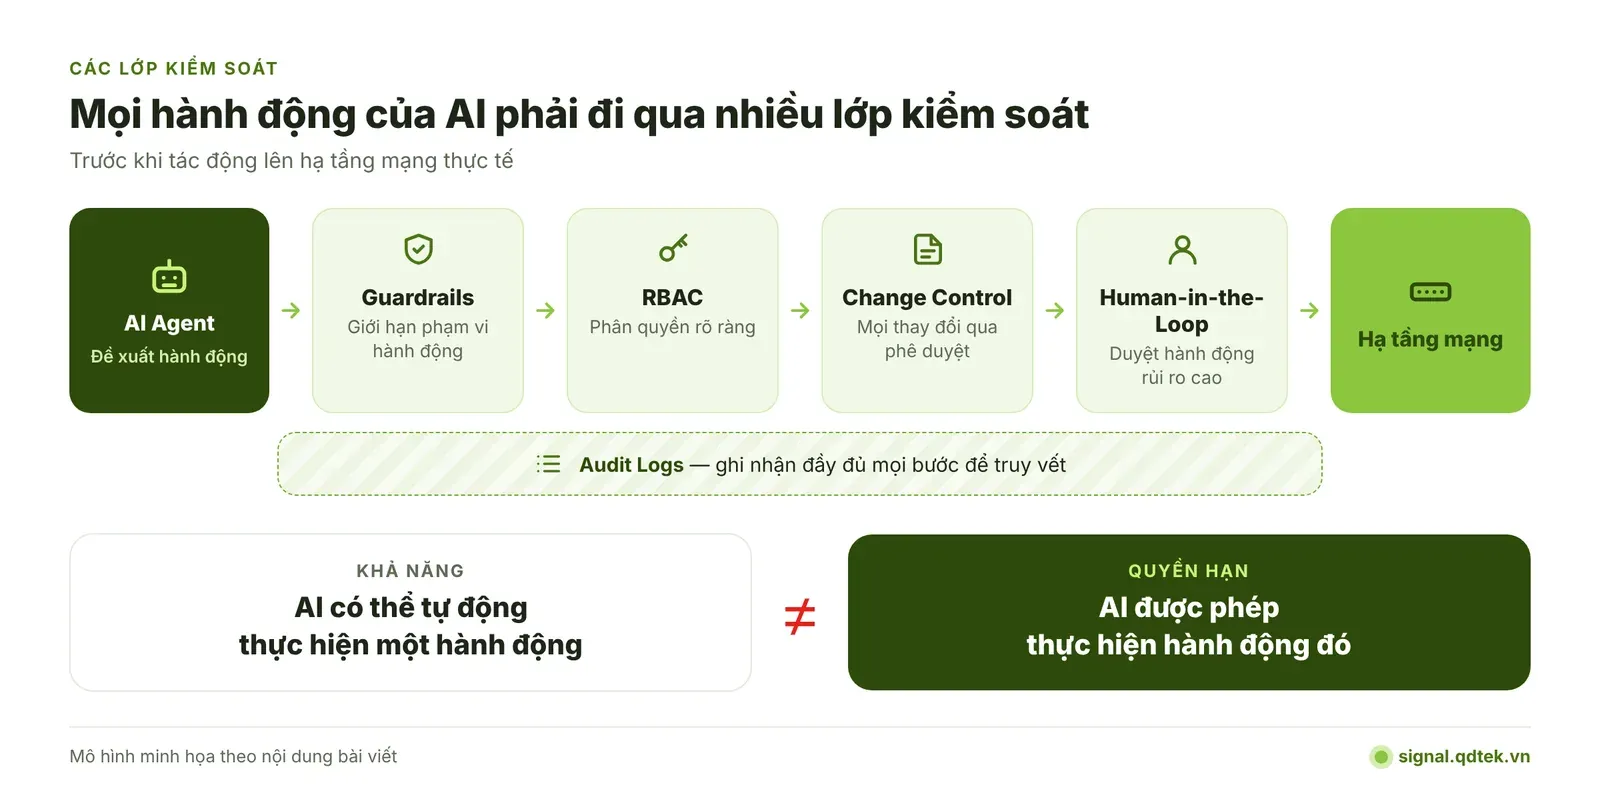
Một nguyên tắc quan trọng: "Khả năng tự động thực hiện một hành động" không đồng nghĩa với "quyền được phép thực hiện hành động đó." Đây là ranh giới mà bất kỳ tổ chức nào triển khai AIOps đều phải xác định rõ.
6. HPE đang tích hợp Juniper, Aruba và OpsRamp ra sao?
Sau sáp nhập, HPE đang từng bước hợp nhất các nền tảng quản trị mạng. Theo Rahim:
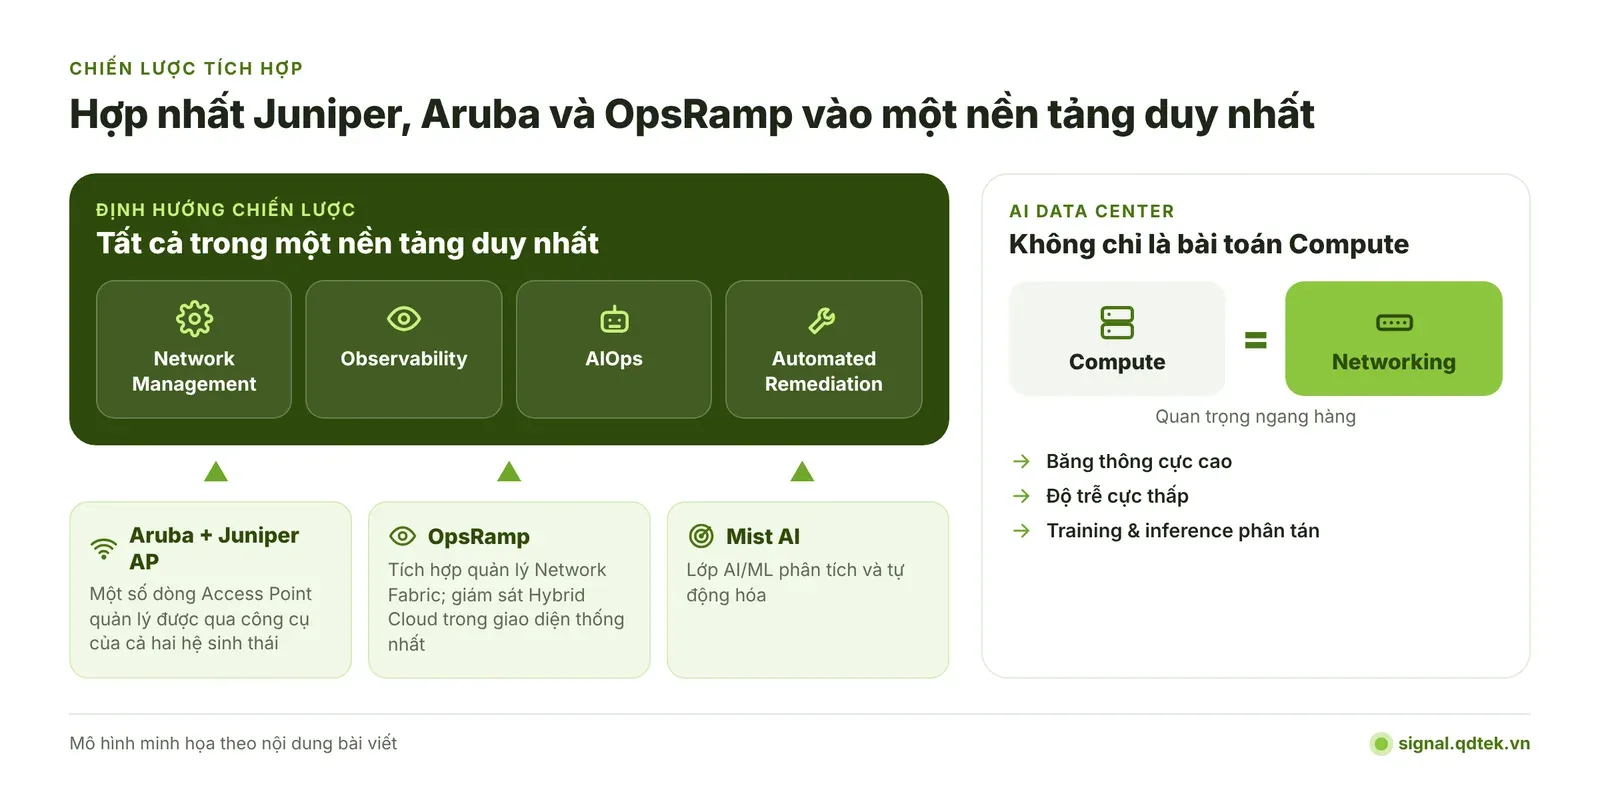
- Một số dòng Access Point có nguồn gốc từ Aruba và Juniper đã có thể được quản lý thông qua công cụ của cả hai hệ sinh thái.
- HPE đã tích hợp khả năng quản lý Network Fabric với OpsRamp, mang Observability vào cùng một giao diện quản trị thống nhất.
- Mist AI (Juniper) cung cấp lớp AI/ML phân tích và tự động hóa, trong khi OpsRamp bổ sung khả năng giám sát Hybrid Cloud.
Định hướng chiến lược rõ ràng: Network Management + Observability + AIOps + Automated Remediation – tất cả trong một nền tảng duy nhất.
Rahim cũng nhấn mạnh rằng AI Data Center ngày nay không chỉ là bài toán về Compute. Networking đang trở thành thành phần quan trọng ngang hàng, đặc biệt khi các mô hình AI lớn yêu cầu băng thông cực cao và độ trễ cực thấp cho quá trình training và inference phân tán.
7. Bức tranh rộng hơn: Không chỉ HPE, cả ngành đang chạy đua
HPE không đơn độc trong cuộc đua AI Networking. Hãy nhìn vào những gì các đối thủ đang làm:
Cisco – với nền tảng DNA Center (nay là Catalyst Center) và AI Network Analytics, Cisco cũng đang tích hợp AI vào quản trị mạng. ThousandEyes (Cisco mua lại) cung cấp khả năng giám sát trải nghiệm người dùng end-to-end. Cisco AI Assistant đang được nhúng vào các sản phẩm bảo mật và networking.
Arista Networks – tập trung vào Data Center và Cloud Networking, Arista đang phát triển CloudVision với các tính năng AIOps và tự động hóa. AVA (Arista Virtual Assistant) sử dụng AI hỗ trợ troubleshooting.
Extreme Networks – nền tảng ExtremeCloud IQ với CoPilot AI, cung cấp phân tích và gợi ý tự động cho quản trị viên mạng.
Fortinet – tích hợp AI vào bảo mật mạng với FortiAIOps, kết hợp giám sát hiệu suất và phát hiện mối đe dọa.
| Hãng | Nền tảng / Công cụ AI | Trọng tâm |
|---|---|---|
| HPE Juniper · Aruba · OpsRamp | Mist AI, Marvis, OpsRamp | Network Management + Observability + AIOps + Automated Remediation |
| Cisco | Catalyst Center (DNA Center), AI Network Analytics, ThousandEyes, Cisco AI Assistant | Quản trị mạng, giám sát trải nghiệm người dùng end-to-end, bảo mật |
| Arista Networks | CloudVision, AVA (Arista Virtual Assistant) | Data Center & Cloud Networking, AIOps, troubleshooting |
| Extreme Networks | ExtremeCloud IQ, CoPilot AI | Phân tích và gợi ý tự động cho quản trị viên mạng |
| Fortinet | FortiAIOps | Bảo mật mạng, giám sát hiệu suất, phát hiện mối đe dọa |
Điểm chung: tất cả đều hướng đến mô hình mạng tự vận hành (autonomous networking), trong đó AI đảm nhận phần lớn công việc giám sát và khắc phục thường nhật. Sự khác biệt nằm ở mức độ tích hợp, dữ liệu training, và phạm vi tự động hóa mà mỗi hãng đạt được.
8. Kỹ sư mạng sẽ làm gì khi AI xử lý gần hết ticket?
Đây là câu hỏi quan trọng nhất với cộng đồng Network Engineer.
Nếu 80–100% công việc hàng ngày – đọc log, kiểm tra interface, phân tích cảnh báo, xử lý ticket thông thường – được tự động hóa, vai trò kỹ sư mạng sẽ không biến mất, nhưng sẽ thay đổi đáng kể.
Những kỹ năng ngày càng quan trọng:
- Network Architecture – Thiết kế hệ thống mạng có khả năng mở rộng, dự phòng, đáp ứng cả workload truyền thống lẫn AI. Hiểu các mô hình Spine-Leaf, Fabric, SD-WAN, SASE và cách chúng tích hợp với hạ tầng AI.
- Automation & Programmability – Thành thạo Python, Ansible, Terraform, API (REST/gRPC), IaC (Infrastructure as Code). Đây không còn là "nice to have" mà là yêu cầu bắt buộc.
- AIOps & Agentic AI – Hiểu cách AI Agent hoạt động: lấy dữ liệu telemetry từ đâu, phân tích sự cố bằng logic gì, thực hiện remediation theo quy trình nào. Kỹ sư cần có khả năng đánh giá và cải thiện các AI workflow này.
- AI Security & Governance – Xác định quyền hạn của AI Agent, thiết kế Guardrails, kiểm soát các hành động có rủi ro. Khi AI có quyền thay đổi cấu hình mạng, việc quản trị quyền trở nên phức tạp hơn nhiều so với RBAC truyền thống.
- Engineering Judgment – Khả năng đánh giá tác động, đưa ra quyết định kỹ thuật và chịu trách nhiệm cuối cùng. AI có thể đề xuất, nhưng con người vẫn cần phê duyệt những thay đổi ảnh hưởng lớn.
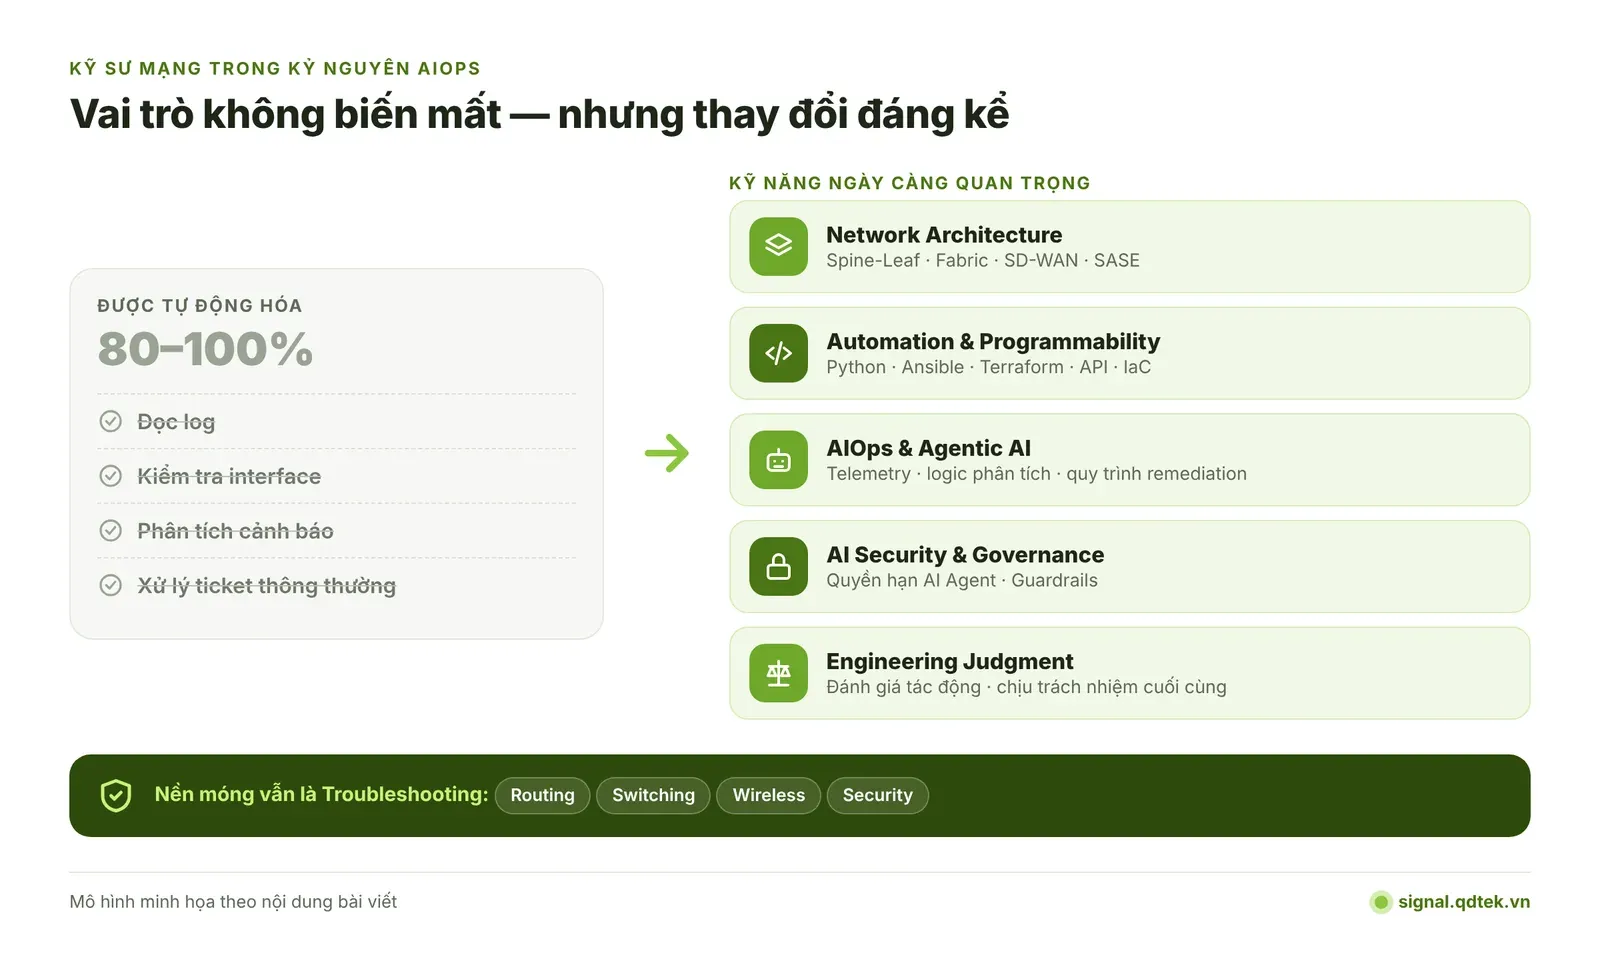
Một điểm cần nhấn mạnh: kinh nghiệm Troubleshooting truyền thống không trở nên vô giá trị. Ngược lại, muốn xây dựng một AI Agent xử lý sự cố mạng tốt, trước tiên phải hiểu thế nào là một quy trình Troubleshooting đúng. Kỹ sư có kiến thức vững về Routing, Switching, Wireless, Security sẽ có lợi thế lớn khi chuyển sang thiết kế và kiểm soát hệ thống Network Automation.
9. Góc nhìn cân bằng: Những rào cản thực tế
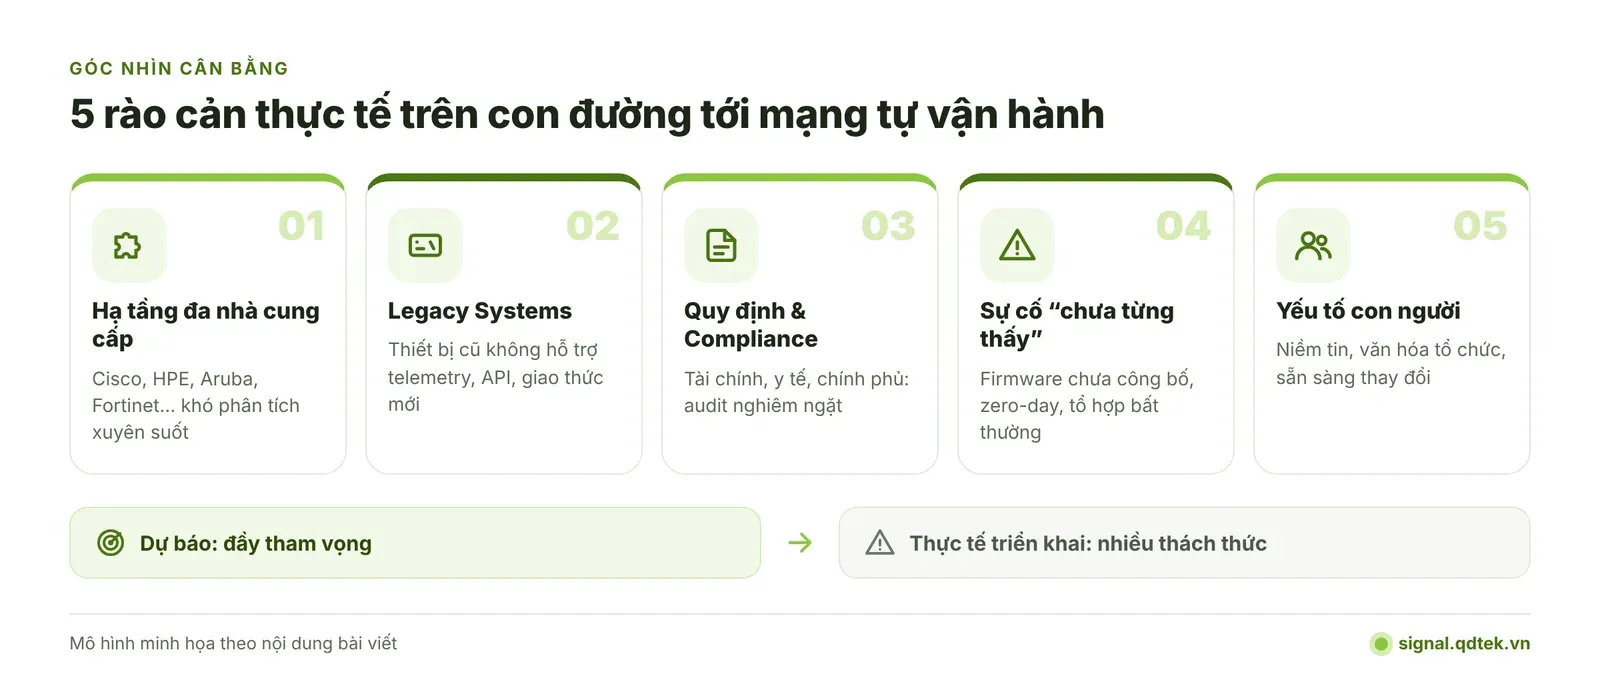
Dự báo của Rahim đầy tham vọng, nhưng thực tế triển khai có nhiều thách thức:
- Hạ tầng đa nhà cung cấp – Hầu hết doanh nghiệp không sử dụng thiết bị của một hãng duy nhất. Khi mạng bao gồm thiết bị từ Cisco, HPE, Aruba, Fortinet và nhiều hãng khác, việc AIOps phân tích và xử lý sự cố xuyên suốt trở nên phức tạp hơn nhiều so với môi trường đồng nhất.
- Legacy Systems – Nhiều tổ chức vẫn vận hành thiết bị cũ không hỗ trợ telemetry hiện đại, API, hoặc các giao thức quản trị mới. AI không thể giám sát và điều khiển những gì nó không "nhìn thấy" được.
- Quy định và Compliance – Trong các ngành như tài chính, y tế, chính phủ, mọi thay đổi trên hạ tầng mạng đều phải tuân thủ quy trình kiểm soát nghiêm ngặt. Việc cho phép AI tự động thực hiện remediation cần đáp ứng các yêu cầu audit và compliance.
- Sự cố "chưa từng thấy" – AI học từ dữ liệu quá khứ. Những sự cố hoàn toàn mới, chưa có tiền lệ – ví dụ lỗi firmware chưa được công bố, tấn công zero-day, hoặc sự kết hợp bất thường của nhiều yếu tố – có thể nằm ngoài khả năng xử lý tự động.
- Yếu tố con người – Niềm tin của đội ngũ vận hành, văn hóa tổ chức, và sự sẵn sàng thay đổi quy trình làm việc là những rào cản "mềm" nhưng không kém phần quan trọng.
Kết luận
Nhận định của Rami Rahim rằng AI sẽ tiến tới xử lý gần như toàn bộ sự cố mạng trong 2–3 năm là một tuyên bố tham vọng, phản ánh tầm nhìn chiến lược của HPE sau thương vụ Juniper. Mức độ khả thi trong thực tế sẽ phụ thuộc vào nhiều yếu tố: từ độ chín của công nghệ, mức độ đồng nhất hạ tầng, cho đến sự sẵn sàng của tổ chức.
Nhưng xu hướng lớn là không thể phủ nhận: Network Operations đang chuyển dịch từ mô hình "con người trực tiếp xử lý mọi thao tác" sang "con người giám sát, thiết kế và kiểm soát các hệ thống tự động."
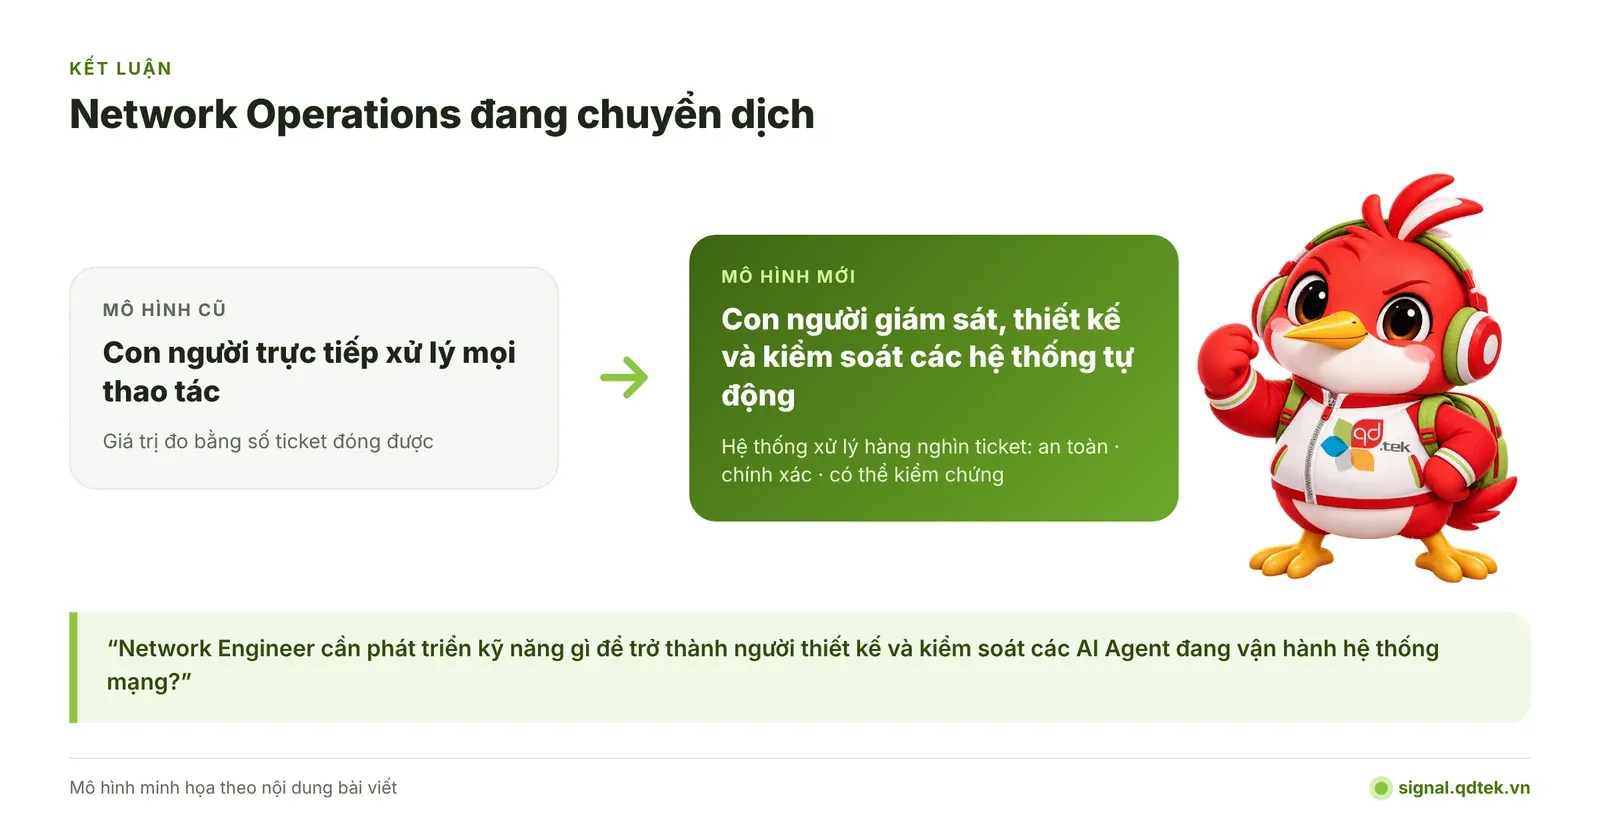
Trong kỷ nguyên Agentic AI, câu hỏi không còn đơn giản là "AI có thay thế Network Engineer không?" Mà là: "Network Engineer cần phát triển kỹ năng gì để trở thành người thiết kế và kiểm soát các AI Agent đang vận hành hệ thống mạng?"
Và có lẽ, những kỹ sư mạng giá trị nhất trong tương lai không phải là người đóng được nhiều ticket nhất, mà là người thiết kế được hệ thống có khả năng xử lý hàng nghìn ticket một cách an toàn, chính xác và có thể kiểm chứng.
Nguồn tham khảo: The Register (11/10/2026) – "HPE's networking boss says AI will handle all trouble tickets without humans in two years."
Chia sẻ bài này